SULAWESI UTARA — Menjalankan model bahasa besar Gemma 4 di NAS terbukti bisa dilakukan tanpa kartu grafis mahal, menurut pengujian yang membandingkan berbagai perangkat keras. Eksperimen memakai GTX 1080 lawas hingga single-board computer menunjukkan perangkat ber-NPU dan VRAM besar tetap unggul, namun NAS menawarkan pendekatan berbeda untuk akses AI lokal sehari-hari. Pendekatan ini cocok untuk pengguna yang ingin privasi data dan tidak keberatan menunggu respons lebih lambat.
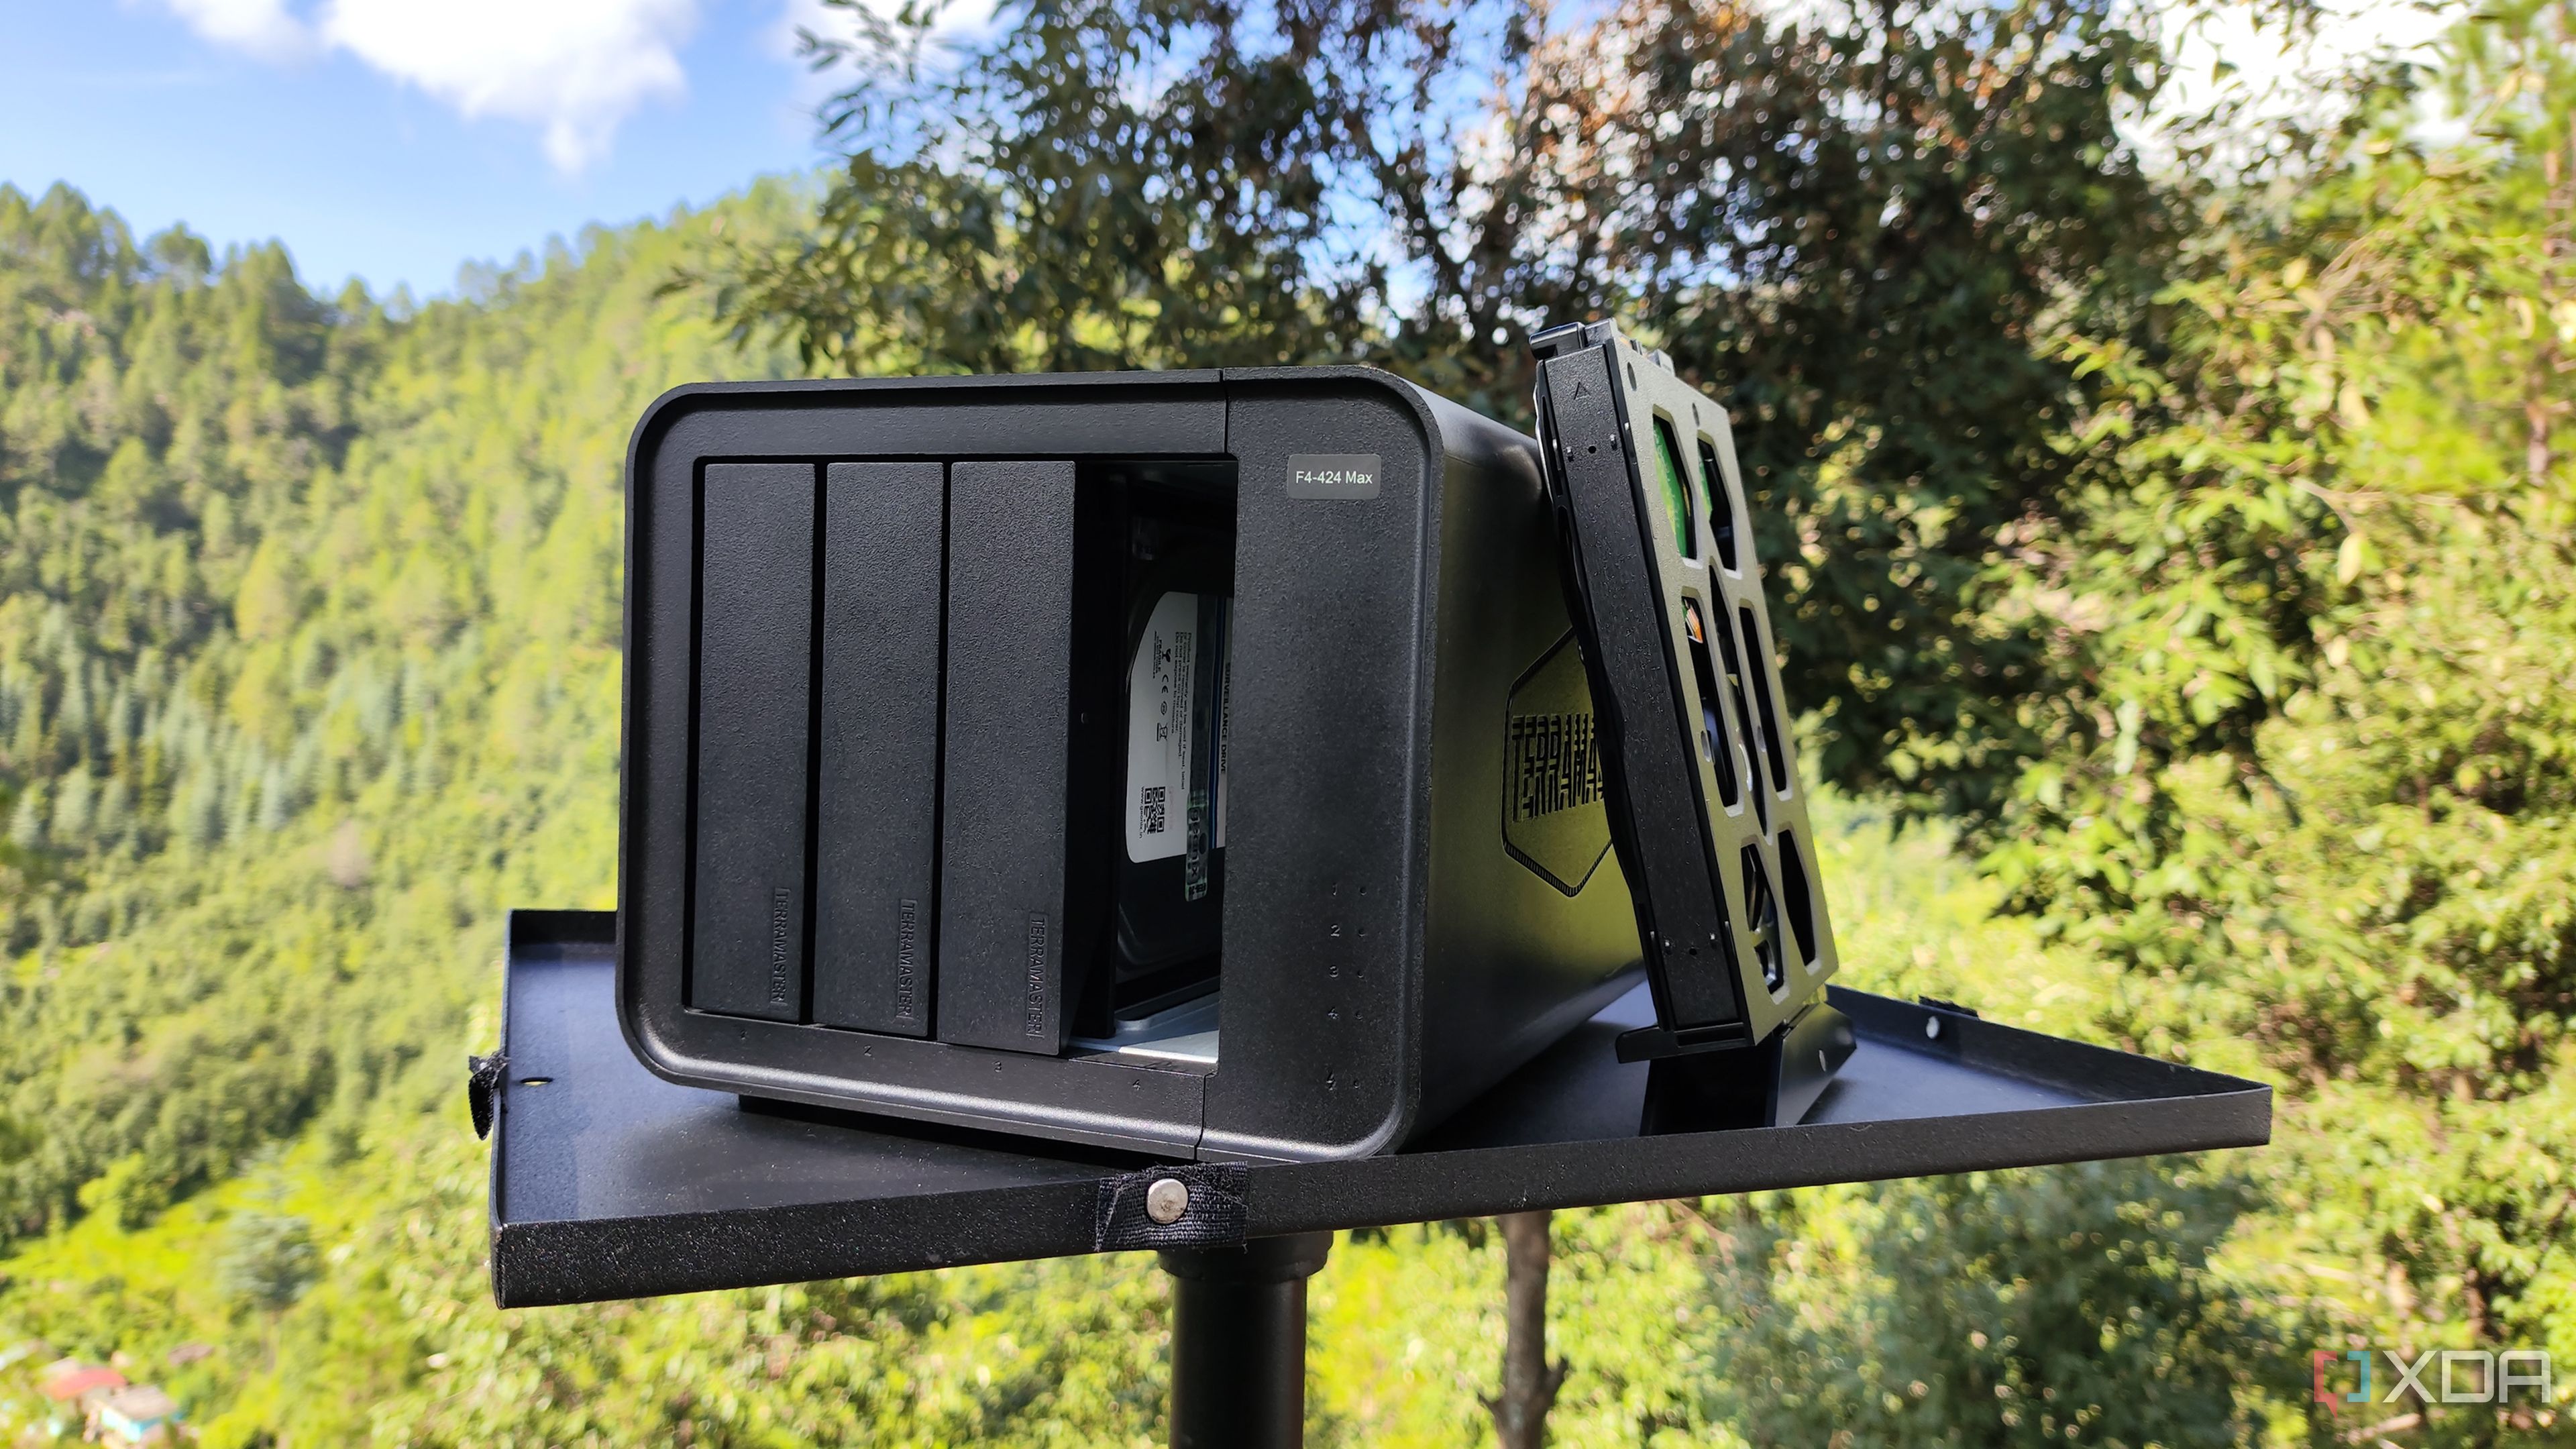
Pengujian inferensi LLM lokal yang dilakukan sejak tahun lalu memakai GTX 1080 menunjukkan pola menarik: perangkat dengan NPU dan kartu grafis ber-VRAM besar memang paling cepat, tapi bukan satu-satunya jalan. NAS yang biasanya dipakai untuk penyimpanan ternyata bisa menjadi host model Gemma 4 dengan hasil yang layak pakai.
Perbandingan mencakup gaming PC, single-board computer berukuran kecil, hingga ponsel lawas. Masing-masing punya karakter berbeda saat menjalankan model bahasa besar. Yang paling mencolok justru bukan soal kecepatan, melainkan bagaimana pola pemakaian berubah ketika model ditempatkan di perangkat yang selalu menyala.
Mengapa NAS Jadi Pilihan Menarik
NAS menyala terus dan terhubung ke jaringan rumah. Menempatkan Gemma 4 di sana berarti model bisa diakses dari perangkat apa pun tanpa perlu menyalakan PC utama. Tidak ada lagi proses loading model setiap kali ingin bertanya.
Konsekuensinya, ekspektasi terhadap kecepatan respons perlu disesuaikan. NAS bukan mesin benchmark. Ia dirancang untuk tugas penyimpanan, bukan komputasi berat. Dengan pengaturan yang tepat, model tetap berjalan, tetapi waktu tunggu per token bisa jauh lebih lama dibanding GPU khusus.
Perangkat Ber-NPU dan VRAM Besar Tetap Tercepat
Pengujian yang sama mengonfirmasi perangkat dengan NPU dan kartu grafis ber-VRAM besar adalah yang terbaik untuk inferensi LLM lokal. Dengan penyetelan yang tepat, perangkat semacam itu bahkan mampu menjalankan model MoE yang berukuran besar.
Namun, kecepatan bukan segalanya. Model MoE memang efisien karena hanya mengaktifkan sebagian parameter per inferensi, tetapi tetap butuh memori besar. Di sinilah perangkat ber-VRAM besar punya keunggulan yang sulit ditandingi NAS kelas rumahan.
Pelajaran Praktis dari Eksperimen Ini
Poin utama yang muncul dari pengujian ini bukan soal perangkat mana yang paling cepat, melainkan soal menyesuaikan ekspektasi. AI lokal di NAS tidak dirancang untuk respons instan. Ia dirancang untuk ketersediaan.
Pengguna yang terbiasa dengan chatbot berbasis cloud mungkin merasa frustrasi dengan jeda yang lebih panjang. Tapi bagi yang mengutamakan privasi data dan ingin model selalu bisa diakses dari jaringan rumah, NAS menjadi kompromi yang masuk akal.
Pendekatan ini juga membuka opsi untuk pengguna Indonesia yang ingin mencoba LLM lokal tanpa membeli GPU mahal. Cukup memanfaatkan NAS yang sudah ada, dengan catatan spesifikasi RAM dan prosesor memadai untuk menjalankan model yang dipilih.
Gemma 4 di NAS bukan solusi untuk semua orang. Tapi bagi yang ingin AI lokal selalu tersedia tanpa menyalakan PC utama, ini pendekatan yang layak dipertimbangkan.